Open Source
GitHub, HuggingFace의 최신 AI 오픈소스 프로젝트를 탐색하세요.
GLM-5.3-Flash(321B MoE)와 DeepSeek-V4.1-Flash-1017(748B MoE)을 개인 GPU에서 실행하는 로컬 추론 엔진이다. 자주 쓰이는 전문가(expert)는 GPU에, 그다음은 RAM에, 나머지는 NVMe SSD에 두고 대화에 따라 옮기며, 설치 시 하드웨어를 측정해 설정을 자동 조정한다. NVIDIA GPU 1~16장을 지원하고 AMD·Windows는 실험적이다. GLM-5.3-Flash용 자체 양자화(Maya-S~L)는 README 기준 FP8 대비 zero-shot 정확도 97.7~99.2%를 유지한다. OpenAI·Anthropic 호환 API와 최대 8개 동시 요청을 지원한다. MIT 라이선스.
ollama
로컬 LLM을 쉽게 실행하는 도구
ggml-org
C/C++로 작성된 로컬 LLM 추론 엔진
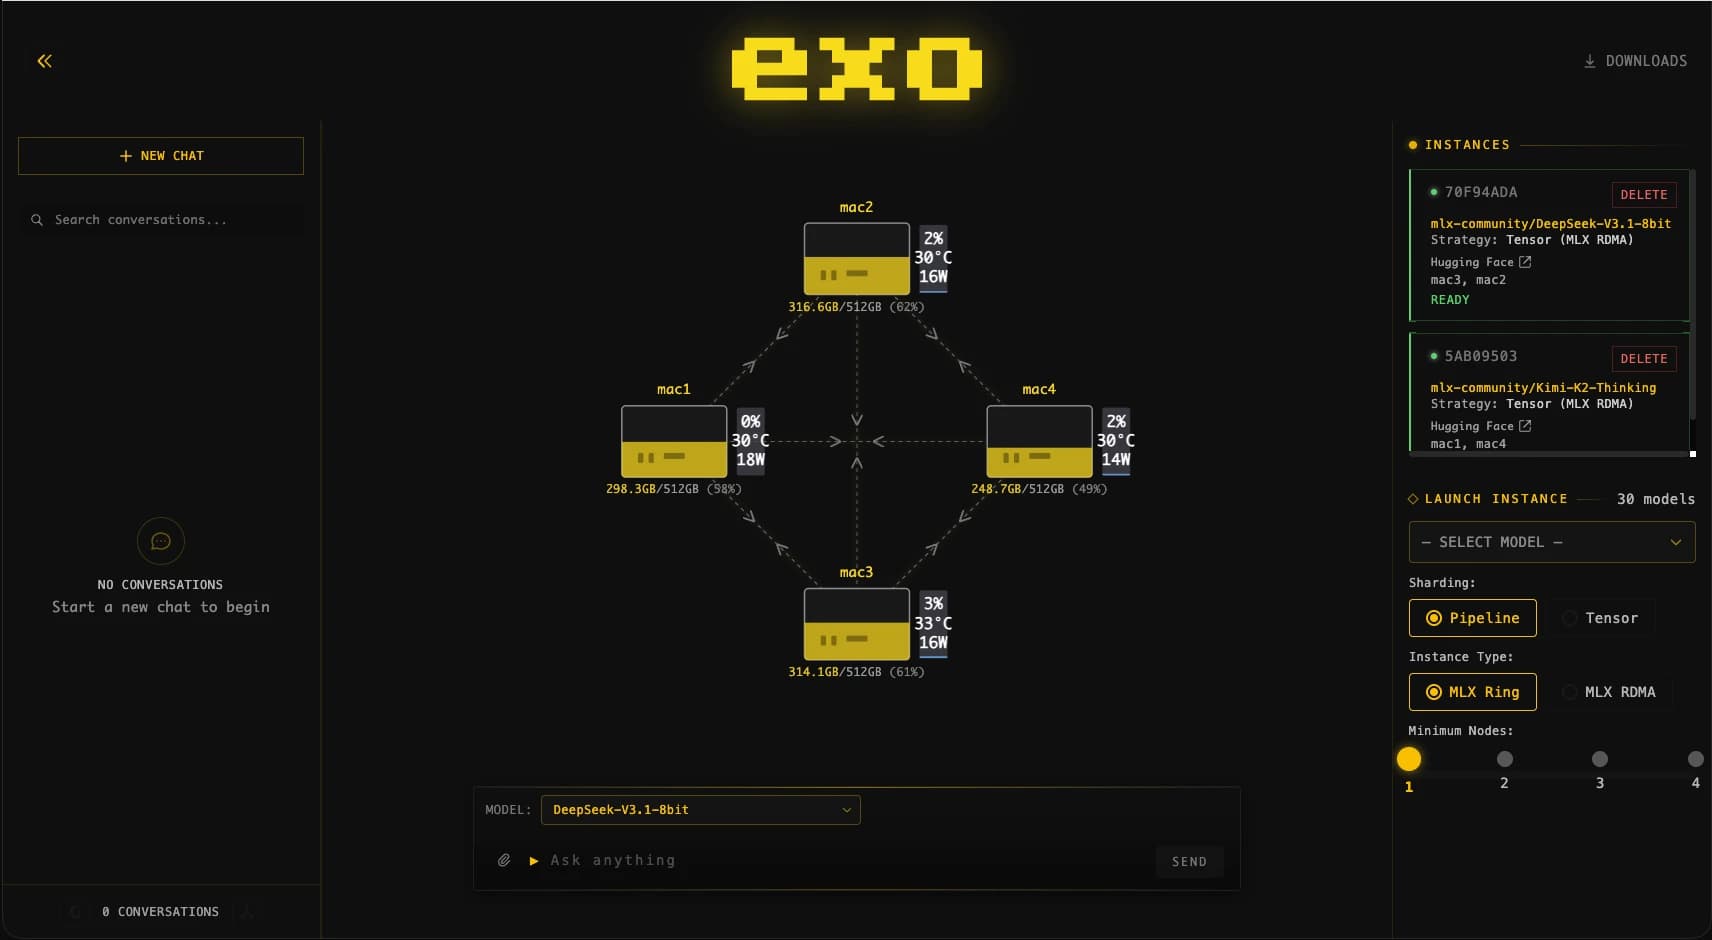
exo-explore
일상 기기를 AI 클러스터로 연결하는 분산 추론 플랫폼
JustVugg
초대형 MoE 모델의 전문가를 디스크에서 스트리밍해 개인 하드웨어에서 돌리는 순수 C 추론 엔진