Open Source
GitHub, HuggingFace의 최신 AI 오픈소스 프로젝트를 탐색하세요.
NVIDIA가 공개한 SM120/SM121 GPU(DGX Spark 등)용 로컬 추론 서버로, 긴 대화·코딩 에이전트·반복 도구 호출을 겨냥한다. Python 패키지 Ignition이 PyTorch·FlashInfer로 커널 튜닝, 컴파일, CUDA 그래프 캡처를 마친 런타임 패키지를 만들고, Rust 런타임 Helios가 Python 없이 서빙한다. KV 캐시와 순환 상태를 하나의 대화 상태로 다뤄 재사용·분기·재개를 지원한다. Qwen3.8·DeepSeek·GLM-5.3 등 레시피를 포함하며, README는 연구용 프로토타입으로 vLLM을 대체하지 않는다고 밝힌다. Apache-2.0 라이선스.
ollama
로컬 LLM을 쉽게 실행하는 도구
ggml-org
C/C++로 작성된 로컬 LLM 추론 엔진
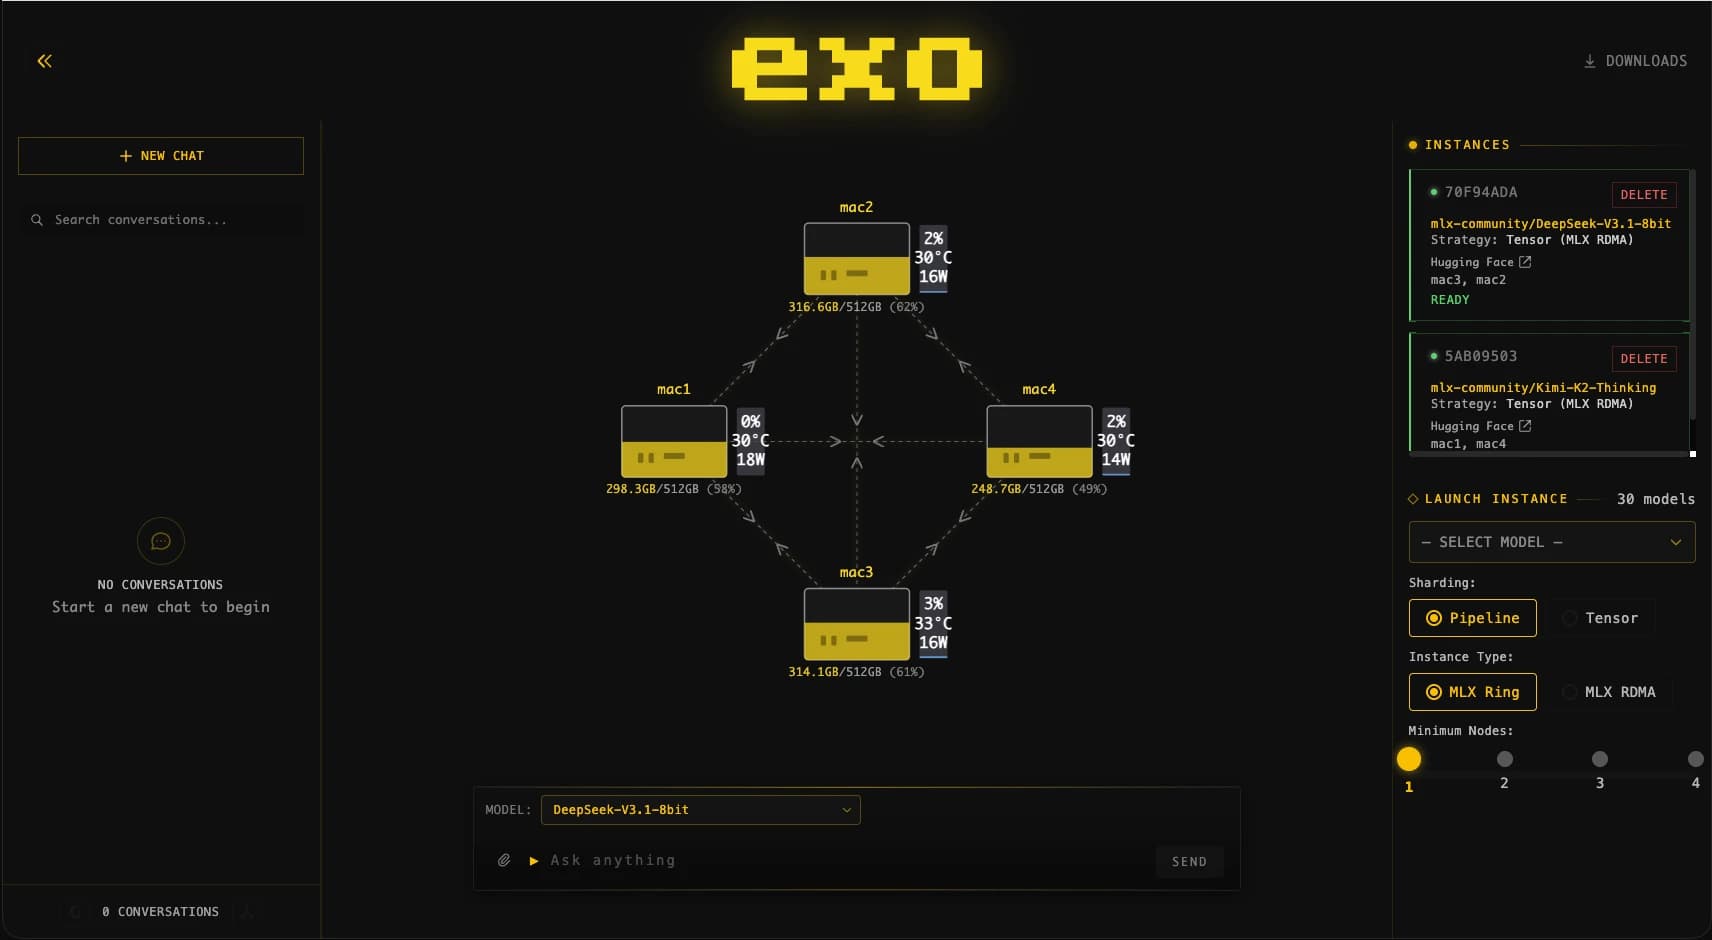
exo-explore
일상 기기를 AI 클러스터로 연결하는 분산 추론 플랫폼
JustVugg
초대형 MoE 모델의 전문가를 디스크에서 스트리밍해 개인 하드웨어에서 돌리는 순수 C 추론 엔진